
7 min de lecture
Comment revenir en arrière après une mise à jour ratée
Une mise à jour peut casser un panier ou un paiement. Le pire moment n’est pas l’incident lui-même, mais celui où personne ne sait quoi restaurer ni comment.
Un retour arrière efficace ne s’improvise pas pendant la panne : il se prépare avant la publication, quand on a encore l’esprit clair.
Ce guide explique comment mettre en place un rollback rapide et fiable, pour transformer une mise à jour ratée en simple incident maîtrisé.
Préparer un rollback avant chaque publication sensible
Identifiez la version saine, les zones touchées et le responsable du déclenchement avant de publier.
Démarrer un essai gratuitVoir les tarifsComprendre le fonctionnement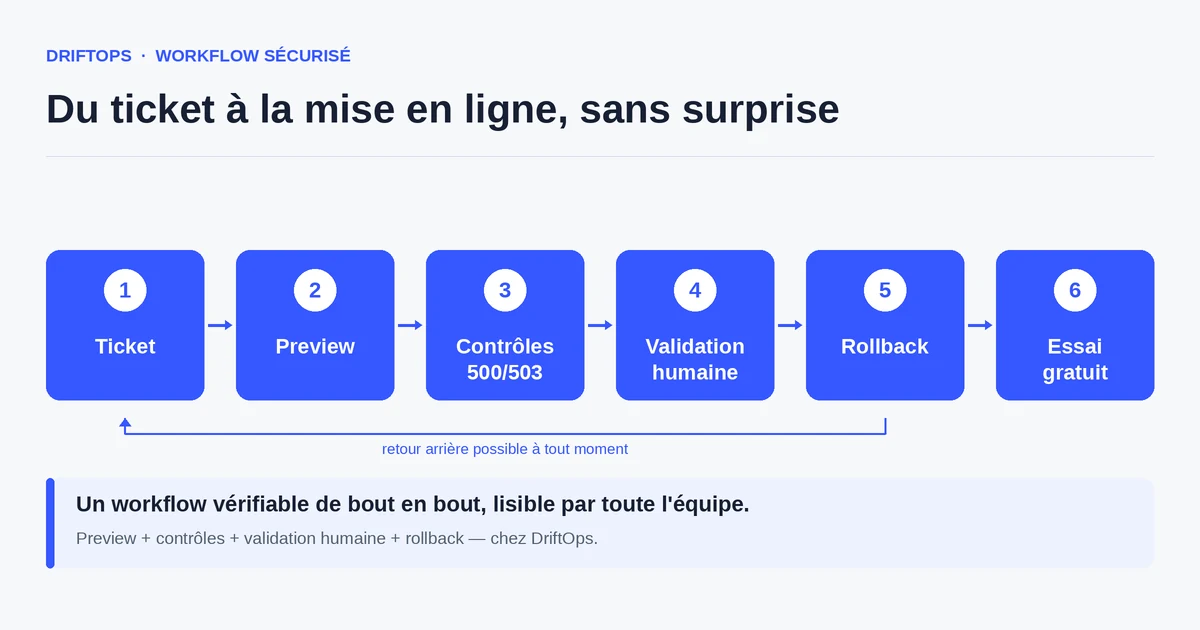
Ce qu’un rollback doit vraiment couvrir
Revenir en arrière ne se limite pas à restaurer des fichiers. Une boutique e-commerce mêle code, base de données, configuration des modules et parfois fichiers médias. Un rollback partiel peut laisser la boutique dans un état incohérent.
Un bon retour arrière identifie à l’avance la version saine de référence : le code, l’état de la base et la configuration qui correspondaient à une boutique fonctionnelle. Sans cette référence, on restaure à l’aveugle.
Il définit aussi le périmètre : certaines données (commandes passées pendant l’incident) ne doivent pas être perdues. Un rollback bien pensé distingue ce qu’on restaure de ce qu’on préserve.
Les risques d’un rollback improvisé
Improviser pendant l’incident coûte du temps, et le temps coûte des ventes. Chercher quelle était la dernière version saine, retrouver une sauvegarde, vérifier qu’elle est exploitable : tout cela allonge la panne.
Un rollback mal préparé peut aggraver la situation : restaurer une base ancienne efface les commandes récentes, ou réintroduit un bug déjà corrigé. La précipitation crée de nouveaux problèmes.
Enfin, l’absence de responsable désigné paralyse la décision : tout le monde attend que quelqu’un tranche, et l’incident s’éternise faute de rôle clair.
La méthode : préparer le retour avant de publier
Avant chaque publication, notez la version saine de référence et préparez le point de restauration. C’est l’assurance qu’on prend avant de partir, pas pendant l’accident.
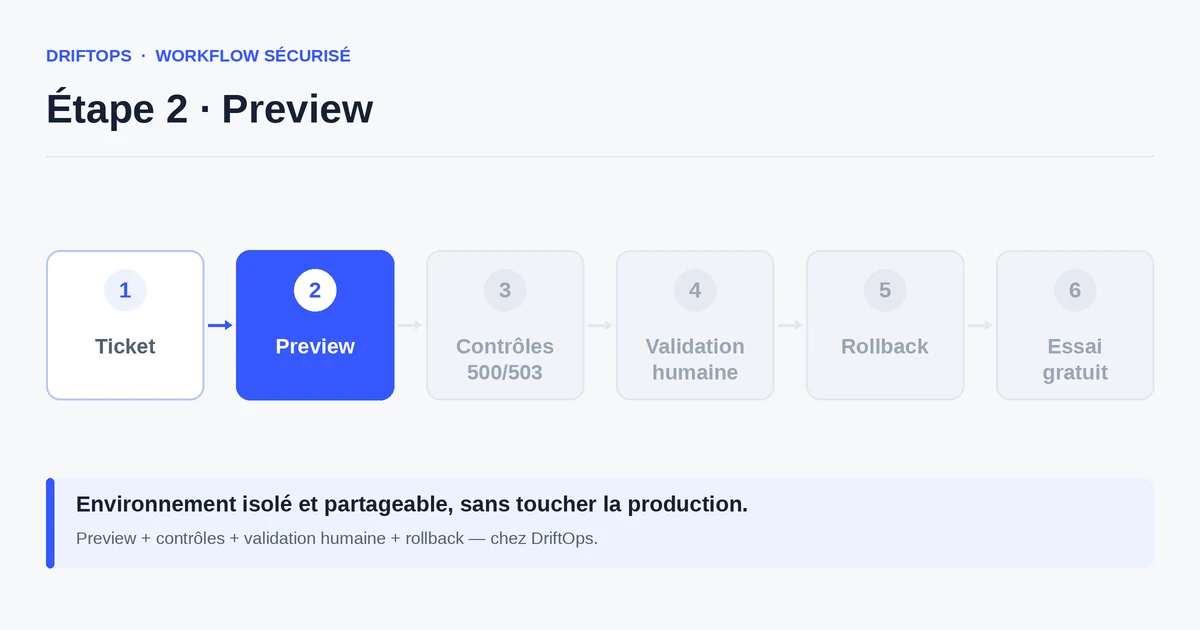
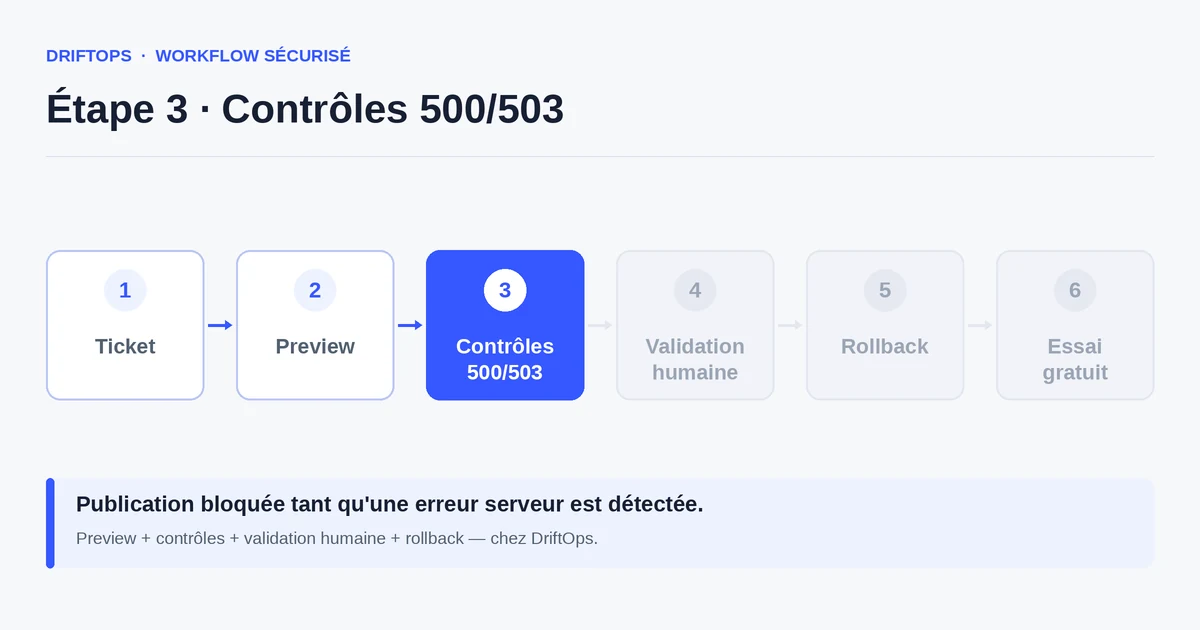
Définissez la procédure : qui déclenche le rollback, sur quels signaux (erreurs 500/503, paiement bloqué, chute de conversion), et ce qu’on préserve (commandes en cours). Une décision préparée se prend en secondes.
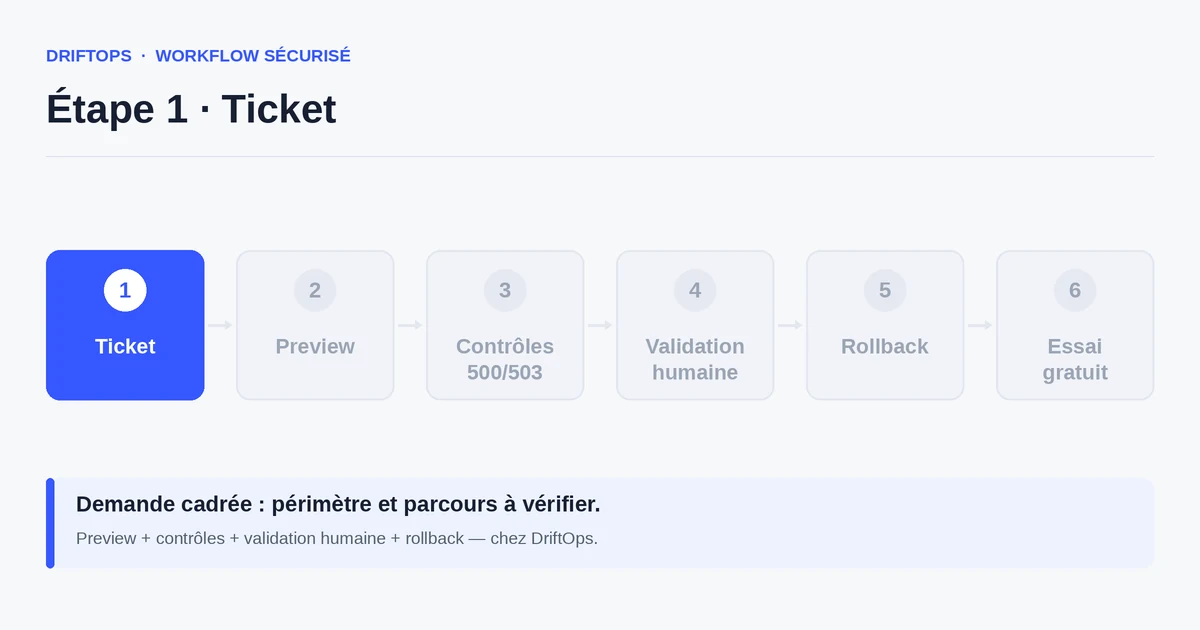
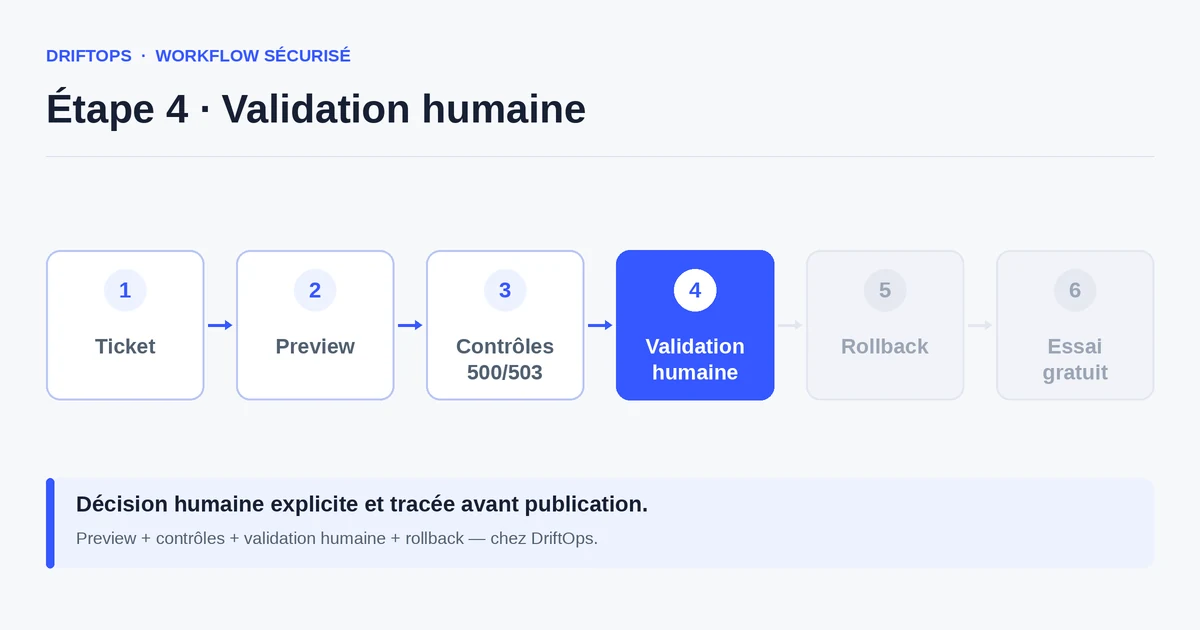
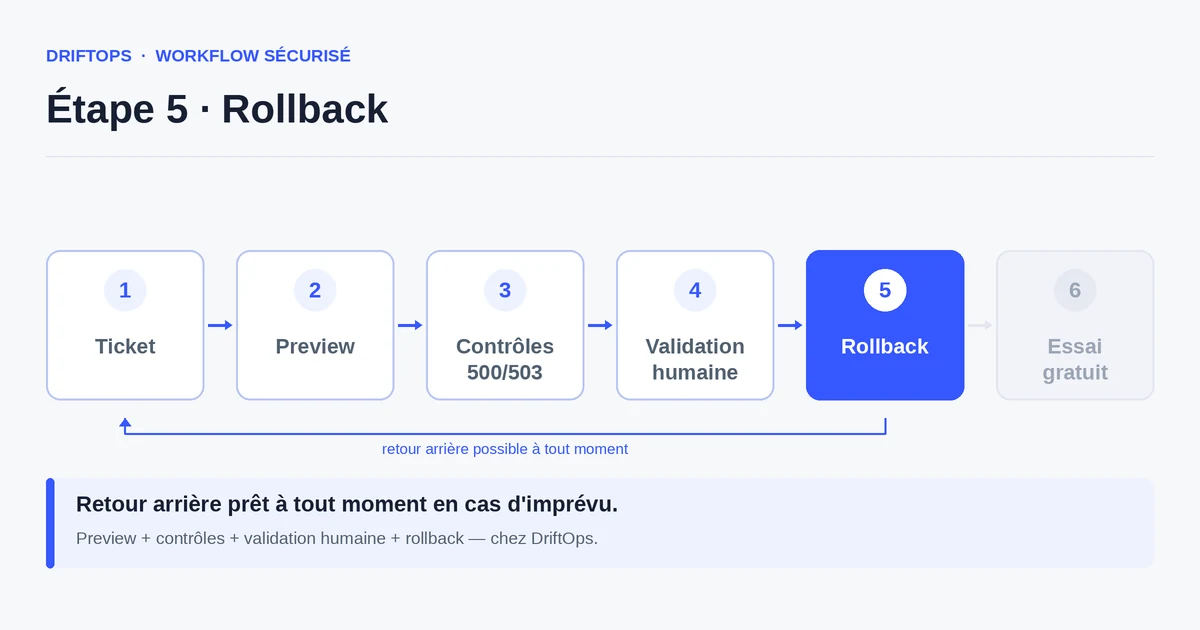
DriftOps garde ce point de retour visible et associe le rollback à une décision humaine. L’équipe sait quelle version était validée et peut y revenir sans reconstruire le contexte dans l’urgence.
Sauvegarde « au cas où » vs rollback préparé
Une sauvegarde « au cas où » donne bonne conscience mais reste théorique : on ne sait pas toujours si elle est complète, exploitable, ni comment la restaurer rapidement.
Un rollback préparé est testé et documenté : version de référence connue, procédure claire, responsable désigné. La différence se mesure en minutes d’interruption le jour de l’incident.
Comparatif PrestaShop, WooCommerce et Magento
| Plateforme | Risque fréquent | Contrôle recommandé |
|---|---|---|
| PrestaShop | Modules, overrides, hooks, traductions et cache Smarty. | Tester pages produit, panier, tunnel, back office et vidage du cache. |
| WooCommerce | Plugins, options WordPress, webhooks, emails et actions planifiées. | Vérifier panier, paiement sandbox, coupons, stock et emails de commande. |
| Magento | Index, cache pleine page, compilation, store views et modules. | Contrôler catalogue, checkout, index, réchauffage du cache et artefact de rollback. |
Comment revenir en arrière après une mise à jour ratée devient plus fiable quand ces différences sont traitées comme des contrôles explicites plutôt que comme des détails serveur.
Cas d’usage : un plugin qui casse les emails de commande
Un plugin WooCommerce est mis à jour. Les paiements continuent de passer, mais les emails de confirmation ne partent plus : le client paie et ne reçoit aucune trace de sa commande.
Parce que le point de retour était préparé, l’équipe revient à la version validée en quelques instants, rétablit les emails, puis corrige le plugin au calme sur une copie.
L’incident dure quelques minutes au lieu de quelques heures, et aucune commande n’est perdue grâce à un périmètre de rollback bien défini.
Checklist d’un rollback prêt à l’emploi
Préparez ces éléments avant chaque publication sensible.
- Version saine de référence identifiée (code, base, configuration).
- Point de restauration créé avant le changement.
- Signaux de déclenchement définis (500/503, paiement, conversion).
- Données à préserver listées (commandes en cours).
- Responsable du déclenchement désigné.
- Procédure de restauration connue et accessible.
- Surveillance prévue dans les minutes suivant la publication.
Mesurer l’efficacité de votre retour arrière
Le principal indicateur est la durée d’interruption en cas d’incident. Un rollback préparé la fait tomber de plusieurs heures à quelques minutes.
Suivez aussi le nombre d’incidents résolus sans perte de données : c’est le signe que le périmètre de restauration est bien pensé.
Conclusion : le calme se prépare à l’avance
Un retour arrière rapide n’est pas une prouesse technique : c’est le résultat d’une préparation faite avant la panne, quand les décisions sont rationnelles.
En identifiant la version saine, le périmètre et le responsable avant de publier, vous réduisez fortement la durée des incidents. DriftOps garde ce plan accessible au bon moment.
Rendre le retour arrière accessible à toute l’équipe
Gardez le point de retour visible et la procédure connue pour décider vite le jour de l’incident.
Démarrer un essai gratuitVoir les tarifsComprendre le fonctionnementQuestions fréquentes
Un rollback se limite-t-il à restaurer des fichiers ?
Non. Il doit couvrir le code, la base et la configuration des modules, tout en préservant les données à ne pas perdre comme les commandes récentes.
Quand faut-il préparer le retour arrière ?
Avant la publication, pas pendant l’incident : c’est la préparation, faite l’esprit clair, qui rend le rollback rapide.
Qui doit déclencher le rollback ?
Un responsable désigné à l’avance, sur des signaux définis, pour éviter que la décision se perde dans l’urgence et que l’incident s’éternise.
Pourquoi une simple sauvegarde « au cas où » ne suffit-elle pas ?
Elle donne bonne conscience mais reste théorique : on ne sait pas toujours si elle est complète, exploitable, ni comment la restaurer rapidement.
Comment un rollback mal préparé peut-il aggraver la situation ?
Restaurer une base trop ancienne efface les commandes récentes ou réintroduit un bug déjà corrigé : la précipitation crée de nouveaux problèmes.
Quels signaux doivent déclencher un retour arrière ?
Des signaux définis à l’avance : erreurs 500/503, paiement bloqué ou chute de conversion juste après la publication.
Comment DriftOps facilite-t-il le retour arrière ?
Il garde le point de retour visible et associe le rollback à une décision humaine : l’équipe sait quelle version était validée et peut y revenir sans reconstruire le contexte.
Comment mesurer l’efficacité de son rollback ?
Suivez la durée d’interruption en cas d’incident, qui doit tomber de plusieurs heures à quelques minutes, et le nombre d’incidents résolus sans perte de données.
Réduire la durée de vos incidents
DriftOps garde le point de retour visible et la décision humaine, pour revenir en arrière sans panique.
Démarrer un essai gratuitVoir les tarifsComprendre le fonctionnement