
19 min de lecture
Checklist avant publication en production
Une mise en ligne ratée sur une boutique ecommerce ne prévient pas. Le panier casse en silence, les emails de commande partent dans le vide, le stock affiche des chiffres faux — et ce n'est souvent qu'un client mécontent qui alerte l'équipe. La publication en production est le moment le plus risqué du cycle de développement ecommerce, précisément parce qu'il concentre des changements de nature très différente : code, configuration, données, modules, cache, droits d'accès. Une checklist structurée par thème permet d'aborder chaque dimension sans rien oublier, et de transformer la validation en décision consciente plutôt qu'en pari.
Ce guide passe en revue huit domaines essentiels à contrôler avant toute publication, avec pour chacun une explication du risque et des vérifications concrètes. Il détaille aussi comment DriftOps automatise une partie de ces contrôles — notamment la détection d'erreurs 500/503 sur la preview et la préparation du rollback — pour que la validation humaine porte sur l'essentiel plutôt que sur des signaux que la machine peut surveiller seule.
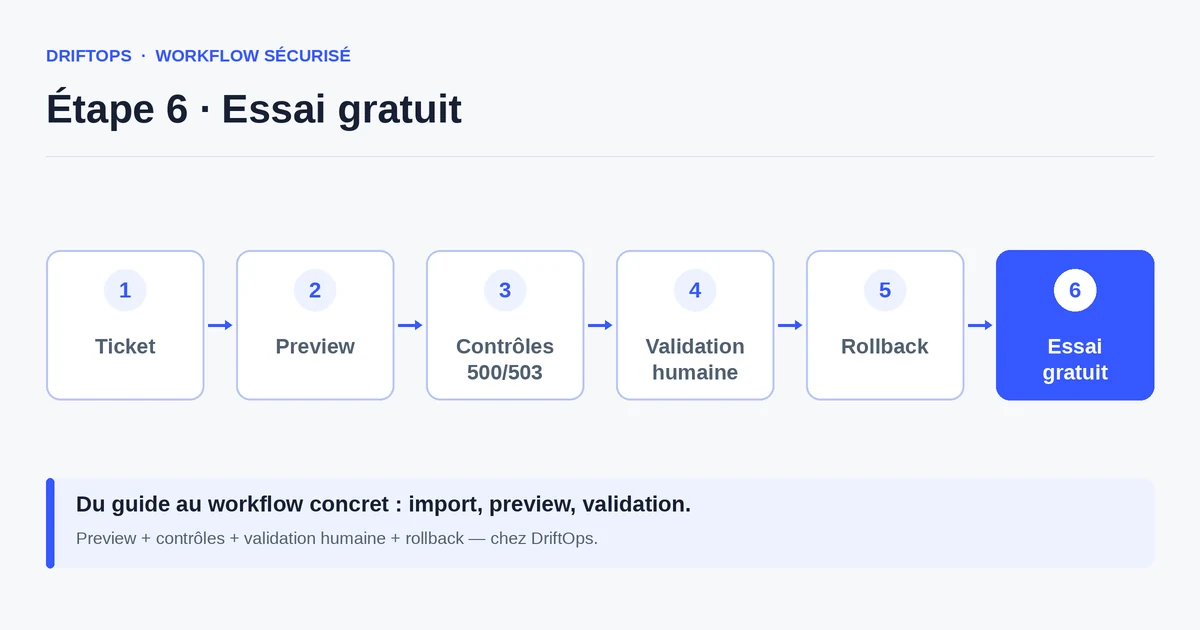
Transformer ce guide en premier essai gratuit
Créez une preview, vérifiez les changements, bloquez les erreurs 500 ou 503 et gardez une validation humaine avant la publication.
Démarrer un essai gratuit Voir les tarifs Comprendre le fonctionnement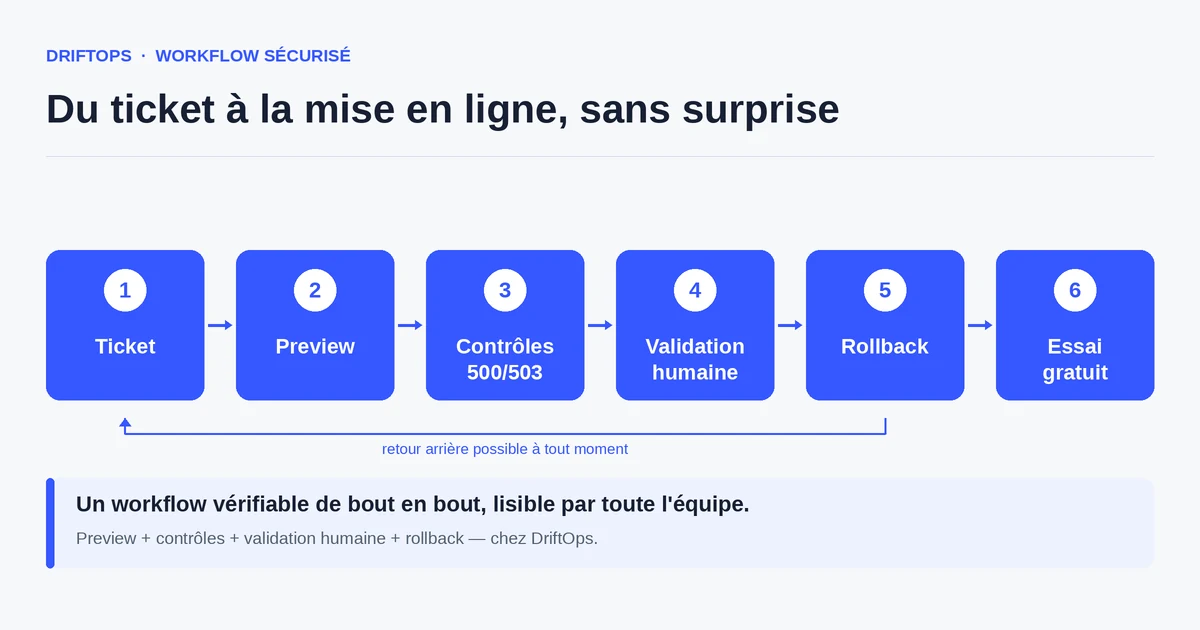
Pourquoi la publication ecommerce est un moment à part
Une boutique ecommerce n'est pas un site vitrine. Elle traite des transactions financières, synchronise des stocks en temps réel, envoie des emails automatisés, gère des règles fiscales par zone géographique et fait tourner des modules tiers qui ne dépendent pas des mêmes cycles de mise à jour que le noyau. Chaque publication touche potentiellement plusieurs de ces couches à la fois. Une migration de base de données mal appliquée peut corrompre les données de prix. Un module mis à jour peut casser un hook de paiement. Un cache mal purgé peut afficher d'anciennes informations de stock après une montée de version.
C'est pour cette raison qu'une checklist de publication ecommerce ne peut pas être générique. Elle doit couvrir explicitement le tunnel d'achat, les données produit, l'état technique du serveur, les signaux SEO et la sécurité — dans cet ordre de priorité ou dans celui qui correspond au périmètre de la modification en cours. La question n'est pas "est-ce que ça marche ?" mais "qu'est-ce que j'ai vérifié, et puis-je expliquer pourquoi j'ai décidé de publier ?"
Les équipes qui travaillent sur PrestaShop font face à des risques concentrés autour des overrides de classes, des modules communautaires et du cache Smarty. Sur WooCommerce, les dépendances entre plugins WordPress, les webhooks de paiement et les scheduled actions sont les points les plus fragiles. Sur Magento, la compilation, les index de catalogue et le cache FPC (Full Page Cache) ajoutent une surface de vérification importante que beaucoup d'équipes sous-estiment lors d'une publication rapide. La checklist doit prendre en compte ces spécificités et non rester à un niveau d'abstraction inutilisable.
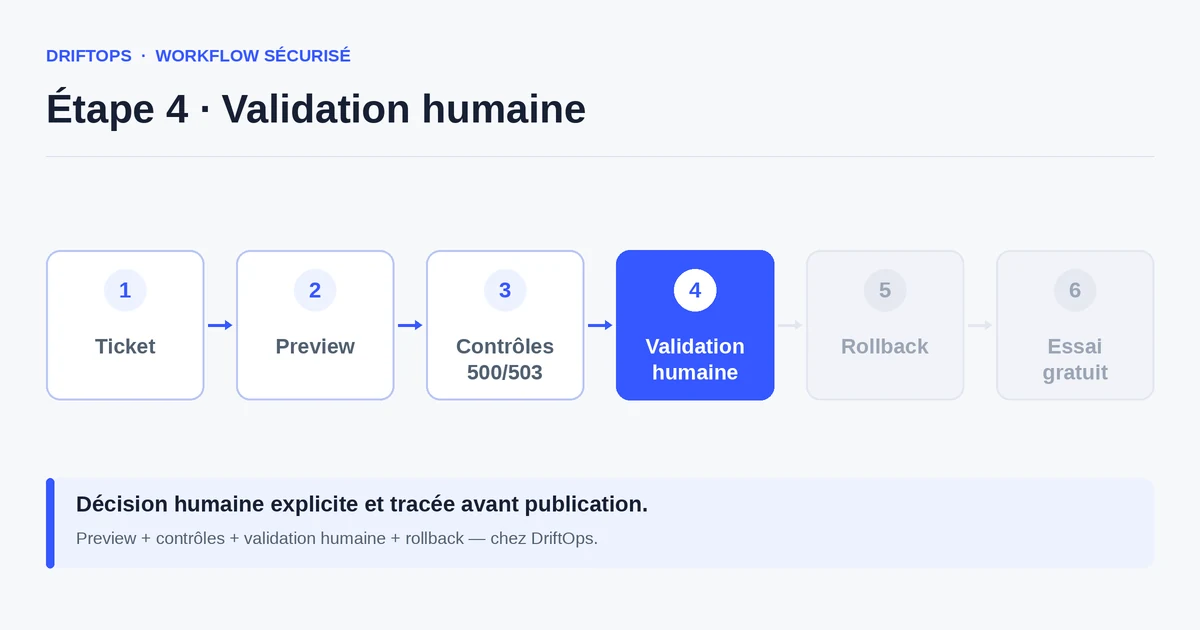
DriftOps part de ce constat : les équipes ecommerce ont besoin de visibilité avant de décider, pas après. Le workflow commence par un ticket qui décrit précisément le changement, crée une preview isolée, déclenche des contrôles automatiques sur les codes HTTP critiques (500, 503), puis demande une validation humaine avant toute publication. Ce cadre ne remplace pas le jugement de l'équipe — il lui donne les éléments nécessaires pour exercer ce jugement sereinement.
Les huit zones de risque à couvrir avant de publier
Organiser les vérifications par thème n'est pas une question de forme : c'est ce qui permet à différents membres de l'équipe de prendre en charge une zone précise, sans se marcher dessus et sans laisser de zones blanches. Voici les huit domaines à traiter systématiquement.
1. Contenu et données
Les textes produit sont-ils à jour ? Les prix affichés correspondent-ils à la base de données, y compris pour les variantes et les promotions en cours ? Le stock est-il cohérent entre le back office et le front ? Si la boutique est multilingue, les traductions sont-elles complètes pour toutes les langues actives ? Un produit affiché "en stock" alors que le stock est à zéro, ou un prix incorrect dans une devise secondaire, génère des commandes impossibles à honorer et de la friction client immédiate.
2. Technique
Les migrations de base de données ont-elles été appliquées dans l'ordre correct ? Le cache applicatif (Smarty pour PrestaShop, object cache pour WooCommerce, FPC pour Magento) a-t-il été vidé ou reconstruit après le déploiement ? Les assets front (CSS, JavaScript) ont-ils été compilés avec les bons paramètres de production — minification activée, source maps désactivées ? La version PHP du serveur cible est-elle compatible avec les dépendances du projet ? Les variables d'environnement de production (clés API, DSN de base de données, mode debug à false) sont-elles correctement configurées ? Les permissions sur les répertoires de cache, d'upload et de logs sont-elles correctes ?
3. Fonctionnel — tunnel d'achat
Le parcours d'achat complet doit être testé de bout en bout sur l'environnement cible, pas seulement sur la preview de développement. Cela signifie : accès à la page produit, ajout au panier, affichage correct des options et variantes, passage en caisse, application d'un coupon de réduction, calcul des taxes par zone, paiement en mode sandbox (sans déclencher une vraie transaction), réception de l'email de confirmation de commande, et accès au back office pour voir la commande créée. Un seul de ces maillons cassé suffit à bloquer les ventes.
4. SEO et indexation
La balise noindex utilisée pendant les développements a-t-elle bien été retirée ? Les redirections 301 sont-elles en place pour les URLs modifiées ou supprimées ? Le sitemap XML est-il à jour et accessible ? Les balises canonical sont-elles correctes sur les pages de catalogue avec filtres ? Un oubli de noindex en production peut désindexer des pages entières en quelques jours.
5. Performance
Le temps de chargement des pages critiques (page produit, panier, checkout) est-il acceptable après le déploiement ? Les images ont-elles été optimisées et servent-elles dans des formats modernes (WebP) ? Le cache de page entière est-il activé et préchargé pour les pages les plus visitées ? Une dégradation de performance après une publication peut augmenter le taux d'abandon panier sans déclencher d'alerte d'erreur visible.
6. Sécurité
HTTPS est-il actif et le certificat valide sur tous les sous-domaines concernés ? Les clés secrètes, tokens d'API et mots de passe ne se trouvent-ils pas dans le code source versionné ou dans des fichiers accessibles publiquement ? Les accès au back office sont-ils protégés par authentification forte ? Le mode debug est-il désactivé (un mode debug actif en production peut exposer des informations de configuration sensibles dans les messages d'erreur) ?
7. Sauvegarde et rollback
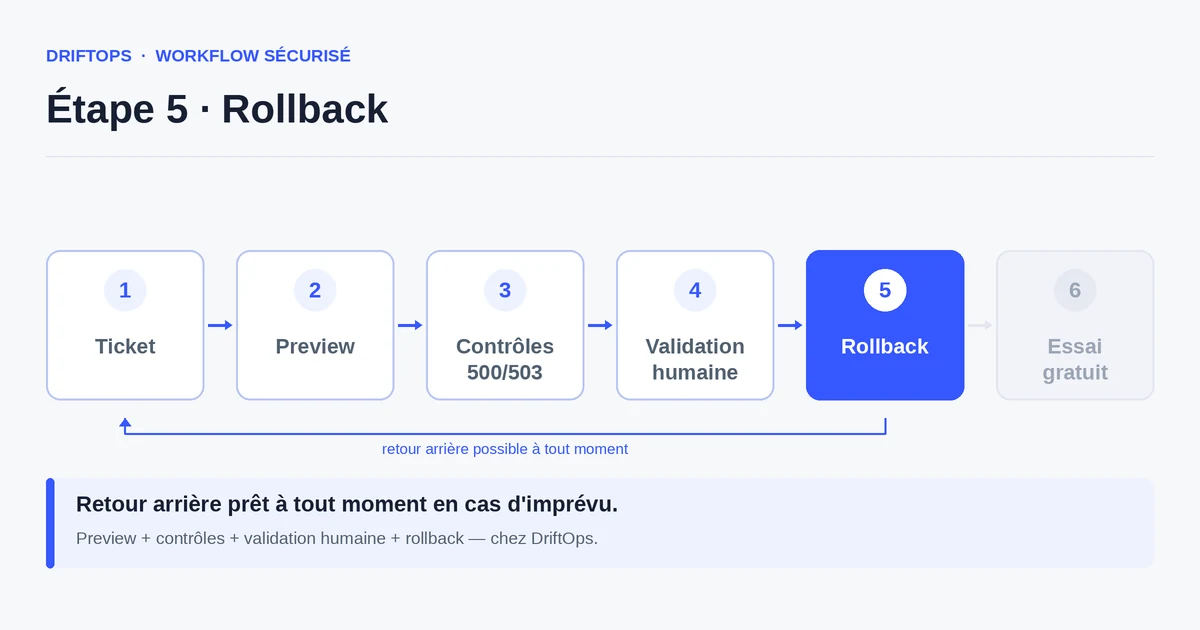
Un backup récent de la base de données et des fichiers existe-t-il, daté d'avant le déploiement ? Un point de retour est-il préparé et documenté, avec la procédure pour le déclencher rapidement si le trafic ou les alertes le justifient ? L'équipe sait-elle qui a l'autorité pour décider un rollback et par quel canal se coordonner ? DriftOps prépare ce point de retour dans le workflow standard, ce qui évite de l'improviser sous pression.
8. Communication
La fenêtre de publication a-t-elle été communiquée à l'équipe support, au client et aux parties prenantes concernées ? Les horaires à faible trafic ont-ils été respectés pour les publications à risque élevé ? Un message d'état ou un mode maintenance est-il prévu en cas d'incident pendant la publication ? Une publication qui surprend l'équipe support crée une désorganisation inutile face aux premiers retours clients.
Comment DriftOps structure la validation avant production
Le workflow DriftOps commence par un ticket. Ce n'est pas une formalité administrative : le ticket force à formuler ce qui change, pourquoi, et quels parcours sont concernés. Cette clarté initiale réduit les zones grises lors de la validation. Un changement qui ne peut pas être décrit en quelques phrases est souvent un changement qui n'est pas prêt à être publié.
Une fois le ticket créé, DriftOps génère une preview isolée de la modification. Cette preview tourne dans un environnement séparé de la production, avec les mêmes données mais sans impact sur les vraies commandes. L'équipe peut la partager au client ou au chef de projet via un lien direct, sans que personne n'ait besoin d'accès SSH ou FTP. Le client peut naviguer, tester le panier, vérifier les textes — et valider ce qu'il voit concrètement.
Pendant que la preview est accessible, DriftOps exécute des contrôles automatiques sur les codes HTTP des pages critiques. Si une page produit retourne une erreur 500, si le checkout répond par un 503, la publication est bloquée automatiquement. Ces contrôles ne remplacent pas le test fonctionnel humain, mais ils éliminent les erreurs les plus grossières avant même que quelqu'un n'ait à naviguer manuellement. Consultez la page Fonctionnement pour le détail des contrôles disponibles.
La validation finale appartient à un humain. L'IA peut analyser, résumer, documenter — mais la décision de publier en production reste tracée, nominative et explicite dans DriftOps. Cette contrainte n'est pas une limitation : c'est une garantie que la publication a été approuvée par quelqu'un qui comprend le contexte, et non déclenchée automatiquement parce que tous les tests sont verts. Un test peut être vert et un scénario métier peut quand même être cassé — c'est précisément pour ça que la validation humaine reste obligatoire.
Le rollback est préparé avant la publication, pas après l'incident. DriftOps conserve le point de retour et documente la procédure associée. Si quelque chose se passe mal dans les minutes suivant la mise en ligne, l'équipe n'a pas à improviser : le plan existe, l'outil est prêt et la décision peut être prise en secondes plutôt qu'en minutes d'affolement. Voir aussi la page Sécurité pour les garanties associées à la gestion des données de preview.
Ce que la méthode classique laisse dans l'angle mort
La méthode classique de publication ecommerce repose généralement sur un accès FTP ou SSH direct, une liste de commandes mémorisées par l'un des développeurs, et une vérification manuelle rapide sur le front après déploiement. Elle peut fonctionner sur une boutique stable avec une équipe réduite qui connaît parfaitement l'environnement. Elle commence à montrer ses limites dès que l'équipe grossit, que les projets se multiplient ou que les intervalles entre les publications s'allongent — parce que la mémoire collective s'efface et que les procédures informelles ne résistent pas aux absences.
Le problème le plus fréquent n'est pas technique mais organisationnel : qui a publié quoi, quand, et pourquoi ? En mode FTP ou SSH direct, cette question reste souvent sans réponse claire. Le développeur qui a fait la mise à jour a parfois quitté l'entreprise, ou la publication a été faite par le client lui-même via un accès panneau d'hébergement. Quand l'incident survient, personne ne dispose d'une trace exploitable pour comprendre ce qui a changé.
L'autre angle mort classique est le cache. Sur PrestaShop, oublier de vider le cache Smarty après une modification de template ou une mise à jour de module fait que la boutique continue d'afficher l'ancienne version pendant des heures ou des jours, même si les fichiers sont correctement déployés. Sur WooCommerce, un plugin de cache tiers peut conserver des pages produit périmées après un changement de prix. Sur Magento, la reindexation et le warmup du cache FPC sont des étapes distinctes que beaucoup d'équipes sautent faute de procédure documentée.
Méthode classique vs DriftOps — ce qui change concrètement
| Etape | Méthode classique | Avec DriftOps |
|---|---|---|
| Traçabilité | Emails, Slack, mémoire — souvent partielle | Ticket structuré, horodaté, lié à la preview |
| Environnement de test | Staging partagé ou absent, données désynchronisées | Preview isolée générée à la demande, URL partageable |
| Contrôles HTTP | Vérification manuelle post-déploiement | Contrôles 500/503 automatiques sur la preview avant publication |
| Validation | Implicite ou par message informel | Validation humaine explicite, tracée dans l'outil |
| Restauration | Improvisation sous pression, backup à localiser | Point de retour préparé avant la publication |
Cette différence de structure ne nécessite pas de compétences DevOps supplémentaires. Elle demande seulement de suivre le workflow plutôt que de contourner les étapes sous prétexte d'urgence.
Cas concrets : agence, freelance, marchand
En agence ecommerce, le scenario le plus fréquent est la mise à jour avant une opération commerciale : soldes, Black Friday, lancement d'une collection. Le client a signé les modifications, le développeur a tout testé sur son environnement local, mais la production est une autre réalité. Les données de prix promotionnels ne sont pas les mêmes, les stocks n'ont pas les mêmes niveaux, et le module de coupon a été configuré différemment depuis le dernier déploiement. Sans preview avec des données proches de la production, la validation du client porte sur quelque chose qui ne ressemble pas à ce qu'il va voir le lendemain matin.
DriftOps résout ce problème en permettant de créer une preview partageable que le client peut visiter directement — sans avoir à expliquer comment accéder à un environnement de staging protégé par authentification HTTP. Le client clique, navigue, valide. Si quelque chose cloche, il le signale avant la mise en ligne plutôt qu'après. L'agence économise le passage en urgence le soir du lancement.
Pour un freelance qui gère plusieurs boutiques en parallèle, la charge mentale est le vrai sujet. Chaque projet a ses propres modules, ses propres exceptions, ses propres particularités de configuration. Sans checklist documentée, la publication repose sur la mémoire du prestataire — et la mémoire défaille toujours au pire moment, sous pression ou en fin de journée. Avoir un cadre identique pour chaque projet — ticket, preview, contrôles, validation, rollback — réduit la charge cognitive et rend les publications reproductibles même sur des boutiques rarement touchées.
Chez un e-commerçant qui gère sa boutique en direct, l'enjeu est différent. Le marchand n'a généralement pas les compétences techniques pour interpréter un log Apache ou diagnostiquer une erreur de compilation Magento. Ce dont il a besoin, c'est de voir : voir la modification sur la preview avant qu'elle soit en ligne, comprendre ce qui a été vérifié, et avoir la certitude qu'un plan de secours existe si ça part en vrille. DriftOps donne cette visibilité sans exiger que le marchand devienne administrateur système.
Checklist maîtresse avant publication en production
Cette checklist regroupe les vérifications essentielles des huit thèmes détaillés dans l'article. Elle est conçue pour être parcourue dans l'ordre avant chaque publication significative. Pour les mises à jour mineures (correction d'un texte, ajustement d'un prix unitaire), un sous-ensemble des points techniques et fonctionnels peut suffire — à condition que ce sous-ensemble soit défini explicitement, et non réduit par habitude ou par pression de temps.
- Contenu et données : textes produit à jour, prix et variantes vérifiés, stock cohérent, traductions complètes pour toutes les langues actives.
- Migrations DB : scripts de migration appliqués dans l'ordre et sans erreur ; intégrité des données vérifiée sur les tables critiques (produits, commandes, clients).
- Cache et assets : cache applicatif purgé ou reconstruit, CSS et JS compilés en mode production, CDN invalidé si applicable.
- Variables d'environnement : mode debug désactivé, clés API de production en place, DSN de base de données correct, pas de secrets exposés dans le code versionné.
- Tunnel d'achat : page produit accessible, ajout au panier fonctionnel, paiement testé en mode sandbox, coupon appliqué correctement, taxe calculée selon les zones actives, email de confirmation reçu, commande visible en back office.
- SEO et indexation : balise noindex absente des pages de production, redirections 301 en place pour les URLs modifiées, sitemap mis à jour, canonical correctes sur les pages de catalogue.
- Sécurité : HTTPS actif et certificat valide, back office protégé par authentification, aucun fichier de configuration sensible accessible publiquement.
- Performance : temps de chargement mesuré sur les pages critiques, images servies en format optimisé, cache de page entière actif et préchargé.
- Contrôles HTTP automatiques : aucune erreur 500 ou 503 sur les pages clés de la preview (DriftOps déclenche ces contrôles automatiquement avant la validation).
- Backup récent : sauvegarde base de données et fichiers datée d'avant le déploiement, accessible et testée.
- Rollback documenté : point de retour identifié, procédure écrite, responsable du déclenchement désigné.
- Communication : fenêtre de publication communiquée à l'équipe support et aux parties prenantes, horaire validé, plan de maintenance prévu si nécessaire.
Cette checklist ne vaut que si elle est réellement parcourue. Le risque principal n'est pas de l'oublier — c'est de la considérer comme acquise parce qu'on l'a déjà fait vingt fois. Les incidents de production arrivent précisément lors des publications "de routine", quand l'attention baisse et que les étapes sont brûlées. La valeur de la checklist est dans sa répétition méthodique, pas dans sa nouveauté.
DriftOps prend en charge automatiquement les contrôles HTTP (point 9) et la préparation du rollback (point 11). Les autres points restent sous la responsabilité de l'équipe, ce qui est normal : ce sont des décisions métier et organisationnelles que seul un humain peut valider avec le contexte complet du projet.
Mesurer la fiabilité du workflow dans le temps
Un workflow de publication s'améliore seulement si on mesure ce qui se passe réellement, pas ce qu'on imagine. Les équipes qui ont le sentiment de "bien publier" découvrent souvent, en regardant leurs indicateurs, qu'elles font plusieurs corrections post-déploiement par mois, que les mises en ligne se concentrent en dehors des horaires de bureau pour limiter l'exposition, et que les discussions après incident durent plus longtemps que les publications elles-mêmes.
Les indicateurs les plus utiles ne sont pas nécessairement les plus sophistiqués. Le nombre d'incidents détectés après mise en ligne (et non avant, sur la preview) est le signal le plus direct de l'efficacité du workflow de validation. Le temps moyen entre la création du ticket et la publication donne une idée de la fluidité du processus — une durée anormalement longue peut indiquer des blocages organisationnels, pas des problèmes techniques. La fréquence des rollbacks et le temps de réaction entre la détection d'un problème et le retour arrière mesurent la robustesse du plan de secours.
DriftOps trace nativement ces moments clés : création du ticket, génération de la preview, résultats des contrôles HTTP, validation humaine, publication, et éventuellement rollback. Cette traçabilité n'est pas un reporting pour sa propre sake — c'est ce qui permet de répondre à "qu'est-ce qui s'est passé ?" six semaines après un incident, sans fouiller dans des fils Slack ou des historiques FTP.
Un autre indicateur sous-estimé est la clarté des discussions de validation. Quand l'équipe dispose d'une preview visible, de contrôles HTTP documentés et d'un rollback préparé, les échanges avant publication deviennent plus courts et plus décisifs. Les questions "tu as testé le panier ?" ou "le cache a été vidé ?" n'ont plus à circuler par email — les réponses sont dans l'outil. Cette économie de coordination est souvent plus précieuse que la suppression d'un incident rare mais spectaculaire.
Pour les équipes qui souhaitent aller plus loin, la FAQ DriftOps couvre les questions fréquentes sur la configuration du workflow et les plans disponibles selon la taille de l'équipe et le volume de déploiements. Le premier essai peut se faire sur une mise à jour limitée — une modification de texte, un ajustement de module — pour apprivoiser le workflow sans pression commerciale.
Conclusion : publier avec des preuves, pas des espoirs
La publication en production ecommerce n'est pas un acte technique isolé. C'est une décision organisationnelle qui engage la boutique, l'équipe et les clients. Une checklist structurée par thème — contenu, technique, fonctionnel, SEO, performance, sécurité, rollback, communication — permet de couvrir les huit dimensions de cette décision sans laisser d'angle mort par oubli ou par habitude.
La valeur de cette checklist est double. Elle protège d'abord contre les incidents prévisibles — ceux qu'une vérification de cinq minutes aurait évités. Elle construit ensuite une culture d'équipe où publier signifie "nous avons vérifié et nous pouvons expliquer pourquoi", plutôt que "on croise les doigts et on surveille les alertes". Cette culture, une fois installée, rend les publications plus régulières, plus sereines et plus faciles à déléguer — parce que le cadre est documenté et non dépendant d'une personne.
DriftOps a été conçu pour réduire la friction de ce cadre, pas pour le remplacer. L'outil automatise ce qui peut l'être — contrôles HTTP, préparation du rollback, traçabilité du workflow — et laisse la décision finale à l'humain qui a le contexte complet. C'est un compromis délibéré : l'automatisation sans validation humaine est plus dangereuse que l'absence d'automatisation, parce qu'elle donne une fausse confiance sans absorber la complexité métier réelle d'une boutique ecommerce.
Si vous n'avez pas encore de workflow structuré pour vos publications, le bon point de départ est de choisir une mise à jour simple, de créer une preview avec DriftOps, de parcourir la checklist de cet article sur cette preview, et de documenter la validation avant de publier. Ce premier passage suffit à révéler les zones qui manquent de visibilité dans votre processus actuel — et à poser les bases d'un workflow reproductible pour toutes les publications suivantes.
Tester le workflow sur une vraie boutique
Créez une preview, vérifiez les changements, bloquez les erreurs 500 ou 503 et gardez une validation humaine avant la publication.
Démarrer un essai gratuit Voir les tarifs Comprendre le fonctionnementQuestions fréquentes
Pourquoi une publication ecommerce est-elle plus risquée qu’une mise en ligne classique ?
Parce qu’elle touche en même temps le code, la configuration en base, les modules tiers, le cache et les droits d’accès d’une boutique qui traite des transactions réelles.
Quelles sont les huit zones de risque à couvrir avant de publier ?
Contenu et données, technique, tunnel d’achat, SEO et indexation, performance, sécurité, sauvegarde et rollback, et communication.
Que faut-il tester précisément dans le tunnel d’achat ?
Le parcours complet de bout en bout : page produit, ajout au panier, options et variantes, coupon, calcul des taxes, paiement en mode sandbox, email de confirmation et accès à la commande en back office.
Pourquoi vérifier la balise noindex avant la mise en ligne ?
Une balise noindex laissée par erreur depuis les développements peut désindexer des pages entières en quelques jours ; il faut aussi contrôler redirections 301, sitemap et canonical.
Quels contrôles DriftOps automatise-t-il dans cette checklist ?
Les contrôles HTTP (aucune 500 ni 503 sur les pages clés de la preview) et la préparation du rollback ; les décisions métier des autres points restent à la charge de l’équipe.
Pourquoi la validation humaine reste-t-elle obligatoire si tous les tests sont verts ?
Un test peut être vert alors qu’un scénario métier est cassé ; seule une personne qui comprend le contexte commercial peut décider de publier en connaissance de cause.
Faut-il appliquer la checklist intégrale même pour un petit changement ?
Pour une mise à jour mineure, un sous-ensemble peut suffire, à condition qu’il soit défini explicitement et non réduit par habitude ou par pression de temps.
Comment savoir si notre workflow de publication s’améliore ?
Mesurez les incidents détectés après mise en ligne plutôt qu’avant, le temps entre la création du ticket et la publication, et la fréquence et la rapidité des rollbacks.
Quel est le piège le plus courant avec cette checklist ?
La considérer comme acquise après vingt fois : les incidents arrivent souvent lors des publications « de routine », quand l’attention baisse et que les étapes sont brûlées.